生信分析入门:组学与单细胞的基本流程
生信能干什么
生物信息分析(生信)回答的是这样一类问题:别人已经测好的公共数据里,藏着哪些和我课题有关的线索?全世界的研究者把高通量测序、芯片数据源源不断地上传到公共数据库,这些数据测一次花了几万甚至几十万,而你下载一份拷贝是免费的。用生信方法在这些数据里筛差异基因、找通路、提假设,不用进实验室、不用花一分钱试剂费,一台普通电脑就能开工——对本科生来说,这是门槛最低、最容易做出「属于自己的发现」的科研切入方式之一。
组里正在推进的课题走的就是「生信分析指导实验」的干湿结合路线。主线基因轴是 NFE2L2(编码 Nrf2,抗氧化应答的主开关)→ SLC7A11 / GPX4(铁死亡的执行环节):Nrf2 一旦失守,SLC7A11/GPX4 这道抗氧化防线垮掉,铁死亡就发生。生信的任务,是在公共数据里为这条轴找线索——哪些基因在肺纤维化里变了、哪些同时挂在铁死亡与 cGAS-STING 通路上、哪些在单细胞分辨率下落在特定的细胞群里。方法骨架参考 2025 年 Biomedicines 上一篇肝纤维化 + 衰老 + 铁死亡的生信分析论文(从 GEO 出发层层交叉、锁定 NQO1 hub 基因再做实验验证),但数据集、基因集和交叉维度都已经换成了我们自己的(见下文)。本篇先讲清每一步「在干什么、为什么」,再盘点课题目前已跑出的真实产出。
先打消一个顾虑:生信不等于要成为程序员。R / RStudio 只是工具,代码可以照着官方教程一步一步抄,抄着抄着就懂了;看不懂的报错直接丢给 AI 助手解释,如今已是组内公认的常规操作。你真正需要的是理解每一步的分析逻辑——这正是本篇要给的。
组学(bulk 转录组):下载 GEO 数据 → limma 筛差异基因 → 多队列取交集 → 与 FerrDb 铁死亡基因集、cGAS-STING 基因池交叉 → 富集分析 → 锁定候选并跨数据集验证 → 湿实验。单细胞转录组:读入矩阵 → 质控 → 标准化 → 降维 → 聚类 → 细胞注释 → 上皮细胞聚焦 → 细胞通讯分析。
本课题的生信数据版图
先把家底盘清楚。bulk 侧目前纳入分析体系的是 7 个 GEO 公共数据集,按「发现 → 镜像 → 验证 → 交叉」分工:
| 数据集 | 类型 | 样本 | 在课题中的角色 |
|---|---|---|---|
| GSE134692 | 人全肺 RNA-seq | 46 IPF vs 26 正常 | 发现队列:主要 DEG 来源 |
| GSE289939 | 小鼠博来霉素全肺 RNA-seq | D0 / D7 / D14 / D21 时间序列 | 与组内 BLM 动物实验互为镜像 |
| GSE150910 | 人肺 RNA-seq(LTRC) | 103 vs 103 | 独立验证队列 |
| GSE53845 | 人全肺芯片 | 40 vs 8 | 芯片平台验证(换平台重复) |
| GSE301181 | 人原代肺成纤维 RNA-seq | 33 IPF vs 10 正常 | cGAS-STING + ISG 分析;三集合交叉的第三集合 |
| GSE110147 | 人肺数据集 | — | 证据链中的弱环,仅作旁证 |
| GSE10667 | 人肺芯片(旧) | — | 已退役,不再纳入当前分析体系 |
单细胞侧一句话:主力数据集是 GSE122960(人肺纤维化单细胞转录组),GSE128033 做独立验证,GSE135893 与 GSE301181 用于回归检验,流程细节见后文单细胞部分。
为什么要摆这么多数据集?公共数据的样本背景各不相同,单个数据集的结论容易是巧合,多个数据集方向一致才敢往下讲。后面你会看到,从「发现队列筛 DEG」到「8 个候选基因跨 4 个数据集验证」,每一步都在用不同的数据集互相牵制。
组学(bulk 转录组)标准流程
「bulk」指测的是一整块组织 / 一群细胞的平均信号(相对单细胞而言)。下面七步就是这套标准流程,也是参考论文的骨架——组内已用上表的数据集把它完整跑通:
1. 从 GEO 数据库下载数据集
GEO(Gene Expression Omnibus,NCBI 旗下的公共数据库)存放全世界上传的芯片与测序数据。挑数据集的标准:疾病要对口、分组要清楚、样本量要合理。我们课题的选法是「一个发现 + 多个验证」:用 GSE134692(人全肺 RNA-seq,46 例 IPF vs 26 例正常)做发现队列,先用它筛出差异基因;再用 GSE150910(LTRC 队列,103 vs 103)和芯片数据 GSE53845(40 vs 8)做独立验证——测序和芯片是两种平台,换平台还能重复的信号更硬;GSE289939(小鼠博来霉素全肺,D0 / D7 / D14 / D21 时间序列)则与组内的博来霉素(BLM)动物实验互为镜像——湿实验做到第几天,就去数据里看第几天的转录组。下载拿到的是一张表达矩阵:行是基因、列是样品,格子里是每个基因在每个样品里的表达量,后续所有分析都在这张表上进行。
2. limma 差异分析:筛出差异表达基因(DEG)
用 R 语言的 limma 包比较「疾病组 vs 正常组」,找出表达量明显不同的基因,即差异表达基因 DEG。常用阈值 |log2FC| > 1 且 p < 0.05,两个指标的含义:
- log2FC(log2 fold change,差异倍数的对数):疾病组相对对照组表达变化的倍数取 log2。log2FC = 1 就是上调 2 倍,= −1 就是下调一半;取对数是为了让上调和下调在数值上对称、便于统计和画图;
- p 值:回答「这个差异是真信号还是抽样运气」——p 越小越有把握认为差异真实存在,p < 0.05 是约定俗成的门槛(更严格可看校正后的 FDR)。
两个条件同时满足的基因才进 DEG 列表:倍数不够大(有统计意义但变化微小)或 p 值不过关(变化大但样品间波动也大)的基因都被挡在外面,避免后续步骤被噪音淹没。组内环境统一 R 4.5.2 + RStudio(旧版本 4.0.3 / 4.3.3 已弃用,免得不同电脑上包版本对不上号);RNA-seq 计数矩阵先经 voom 转换再进 limma 线性模型,芯片矩阵归一化后直接进 limma。三个队列各自跑完 limma,就得到各自一份 DEG 列表——它们是下一步交叉的原料。
3. 与疾病基因集交叉:DEG ∩ 基因集 = 候选基因
光有 DEG 还不够——一次分析动辄筛出上千个差异基因,捞不出重点。生信的经典思路是拿「跟某生物学过程相关的已知基因集」来交叉:从 FerrDb 数据库下载铁死亡相关基因集(我们课题的另一条交叉轴是 cGAS-STING 通路基因池),然后取交集:
差异基因 DEG ∩ 疾病相关基因集 = 候选基因(既在病人样品里变了,又和铁死亡 / cGAS-STING 有关)
这一步把「数据里观察到的变化」和「文献里积累的知识」缝在一起。我们课题的实际产出可以当例子:三个队列的 DEG 取交集得到 280 个基因,且上调 / 下调方向 100% 一致;这份交集再与 FerrDb 交叉,留下 54 个铁死亡相关基因;进一步把五个队列都纳入取共识,得到 167 个共识铁死亡基因。交叉维度越多,剩下的基因故事越聚焦——这就是参考论文「肝纤维化 × 衰老 × 铁死亡」三重交叉的同一套讲法。
4. GO 与 KEGG 富集分析:这批基因在干什么
拿到候选基因列表后,用 clusterProfiler 包做富集分析,回答「这批基因集中在哪些功能上」。GO(Gene Ontology)从三个角度归类:生物过程(参与什么生理活动,如细胞对氧化应激的反应)、细胞成分(位于哪里,如细胞膜、线粒体)、分子功能(干什么活,如酶活性、结合功能);KEGG 则把基因映射到已知信号通路(如铁死亡通路、PI3K-Akt 通路)上。富集的判定同样看 p < 0.05:如果候选基因在「铁死亡」通路里富集,说明疾病状态下这条通路被整体扰动,而不是一两个基因的孤立波动。作图用 SRplot 在线工具(气泡图、柱状图点点鼠标就出),论文里那些好看的气泡图大多从这里来。在 GSE301181(人原代肺成纤维)里,我们还专门看了 cGAS-STING 下游干扰素刺激基因(ISG)的富集情况——它的富集方向,为后面的三集合交叉提供了通路层面的依据。
5. PPI 网络 + hub 基因:从网里捞出核心
把候选基因扔进 STRING 数据库构建蛋白互作(PPI)网络——蛋白之间有物理或功能上的相互作用,STRING 按已知证据把它们连成一张网。网络文件导入 Cytoscape 软件,用其 cytoHubba 插件按连接度等算法给基因排序,排在最前面的就是 hub(核心)基因——它们像网络中的交通枢纽,牵一发动全身,是最值得优先做实验验证的对象。参考论文正是走完这一步锁定了 NQO1;我们课题在 PPI 之外,更多依赖「多集合交叉 + 跨数据集验证」来收敛候选(见下文 图 2、图 3)——两条路都是常规做法,互为补充。
6. 免疫浸润分析:看清免疫细胞构成
组织测到的信号其实是各种细胞混在一起的平均值,其中免疫细胞的构成比例深刻影响疾病进程。免疫浸润分析(如 CIBERSORT 等工具)从表达矩阵反推每个样品里各类免疫细胞(巨噬细胞、T 细胞、中性粒细胞……)的估计比例,再看疾病组和对照组的比例变化、以及 hub 基因表达与某类免疫细胞比例的相关性——这常常能给出「候选基因可能通过招募 / 调节某类免疫细胞发挥作用」的额外证据。我们后来在单细胞里看到的「SPP1⁺ 巨噬细胞输出轴」(图 5),方向上和这类分析的预期是吻合的。
7. 湿实验验证:干湿结合的落脚点
生信给出的所有结论本质上都只是假设:数据集是别人测的,样品背景你控制不了。所以最后一步是回到实验室,用 qPCR(mRNA 水平)、Western Blot(蛋白水平)、免疫组化(组织原位定位)在自己的样品或独立数据集上验证候选基因的差异是否成立。生信提出假设 → 湿实验验证,这就是「干湿结合」——缺了最后这一步,前面的分析只是漂亮的推测。值得一提的是镜像思路:GSE289939 是博来霉素诱导的小鼠肺纤维化时间序列,与组内的 BLM 动物实验共用同一条时间轴,生信在公共数据里看到的动态变化,可以直接和自己的实验取样点对照,这是干湿结合最具体的样子。
第一次跑流程时,照着 limma、clusterProfiler 的官方文档一步步抄代码,先在 GSE134692 上跑通「下载 → DEG → 富集」这条最短线,先不管看不看得懂每个参数;组内归档的脚本可以直接对照着看。跑通之后回头改一个阈值看结果怎么变,理解会比看十篇教程都深。报错是常态,把英文报错原样丢给 AI 助手问「这在 R 里为什么错」,通常一分钟内能解决。
已完成的生信产出
前面讲的流程不是纸上谈兵:bulk 侧 7 个数据集的分析体系已经跑通,单细胞侧也产出了第一批图。这一节盘点目前的关键产出——既是进展记录,也可以当作「流程跑完长什么样」的样例来看。
bulk:三集合交叉锁定 8 个候选基因
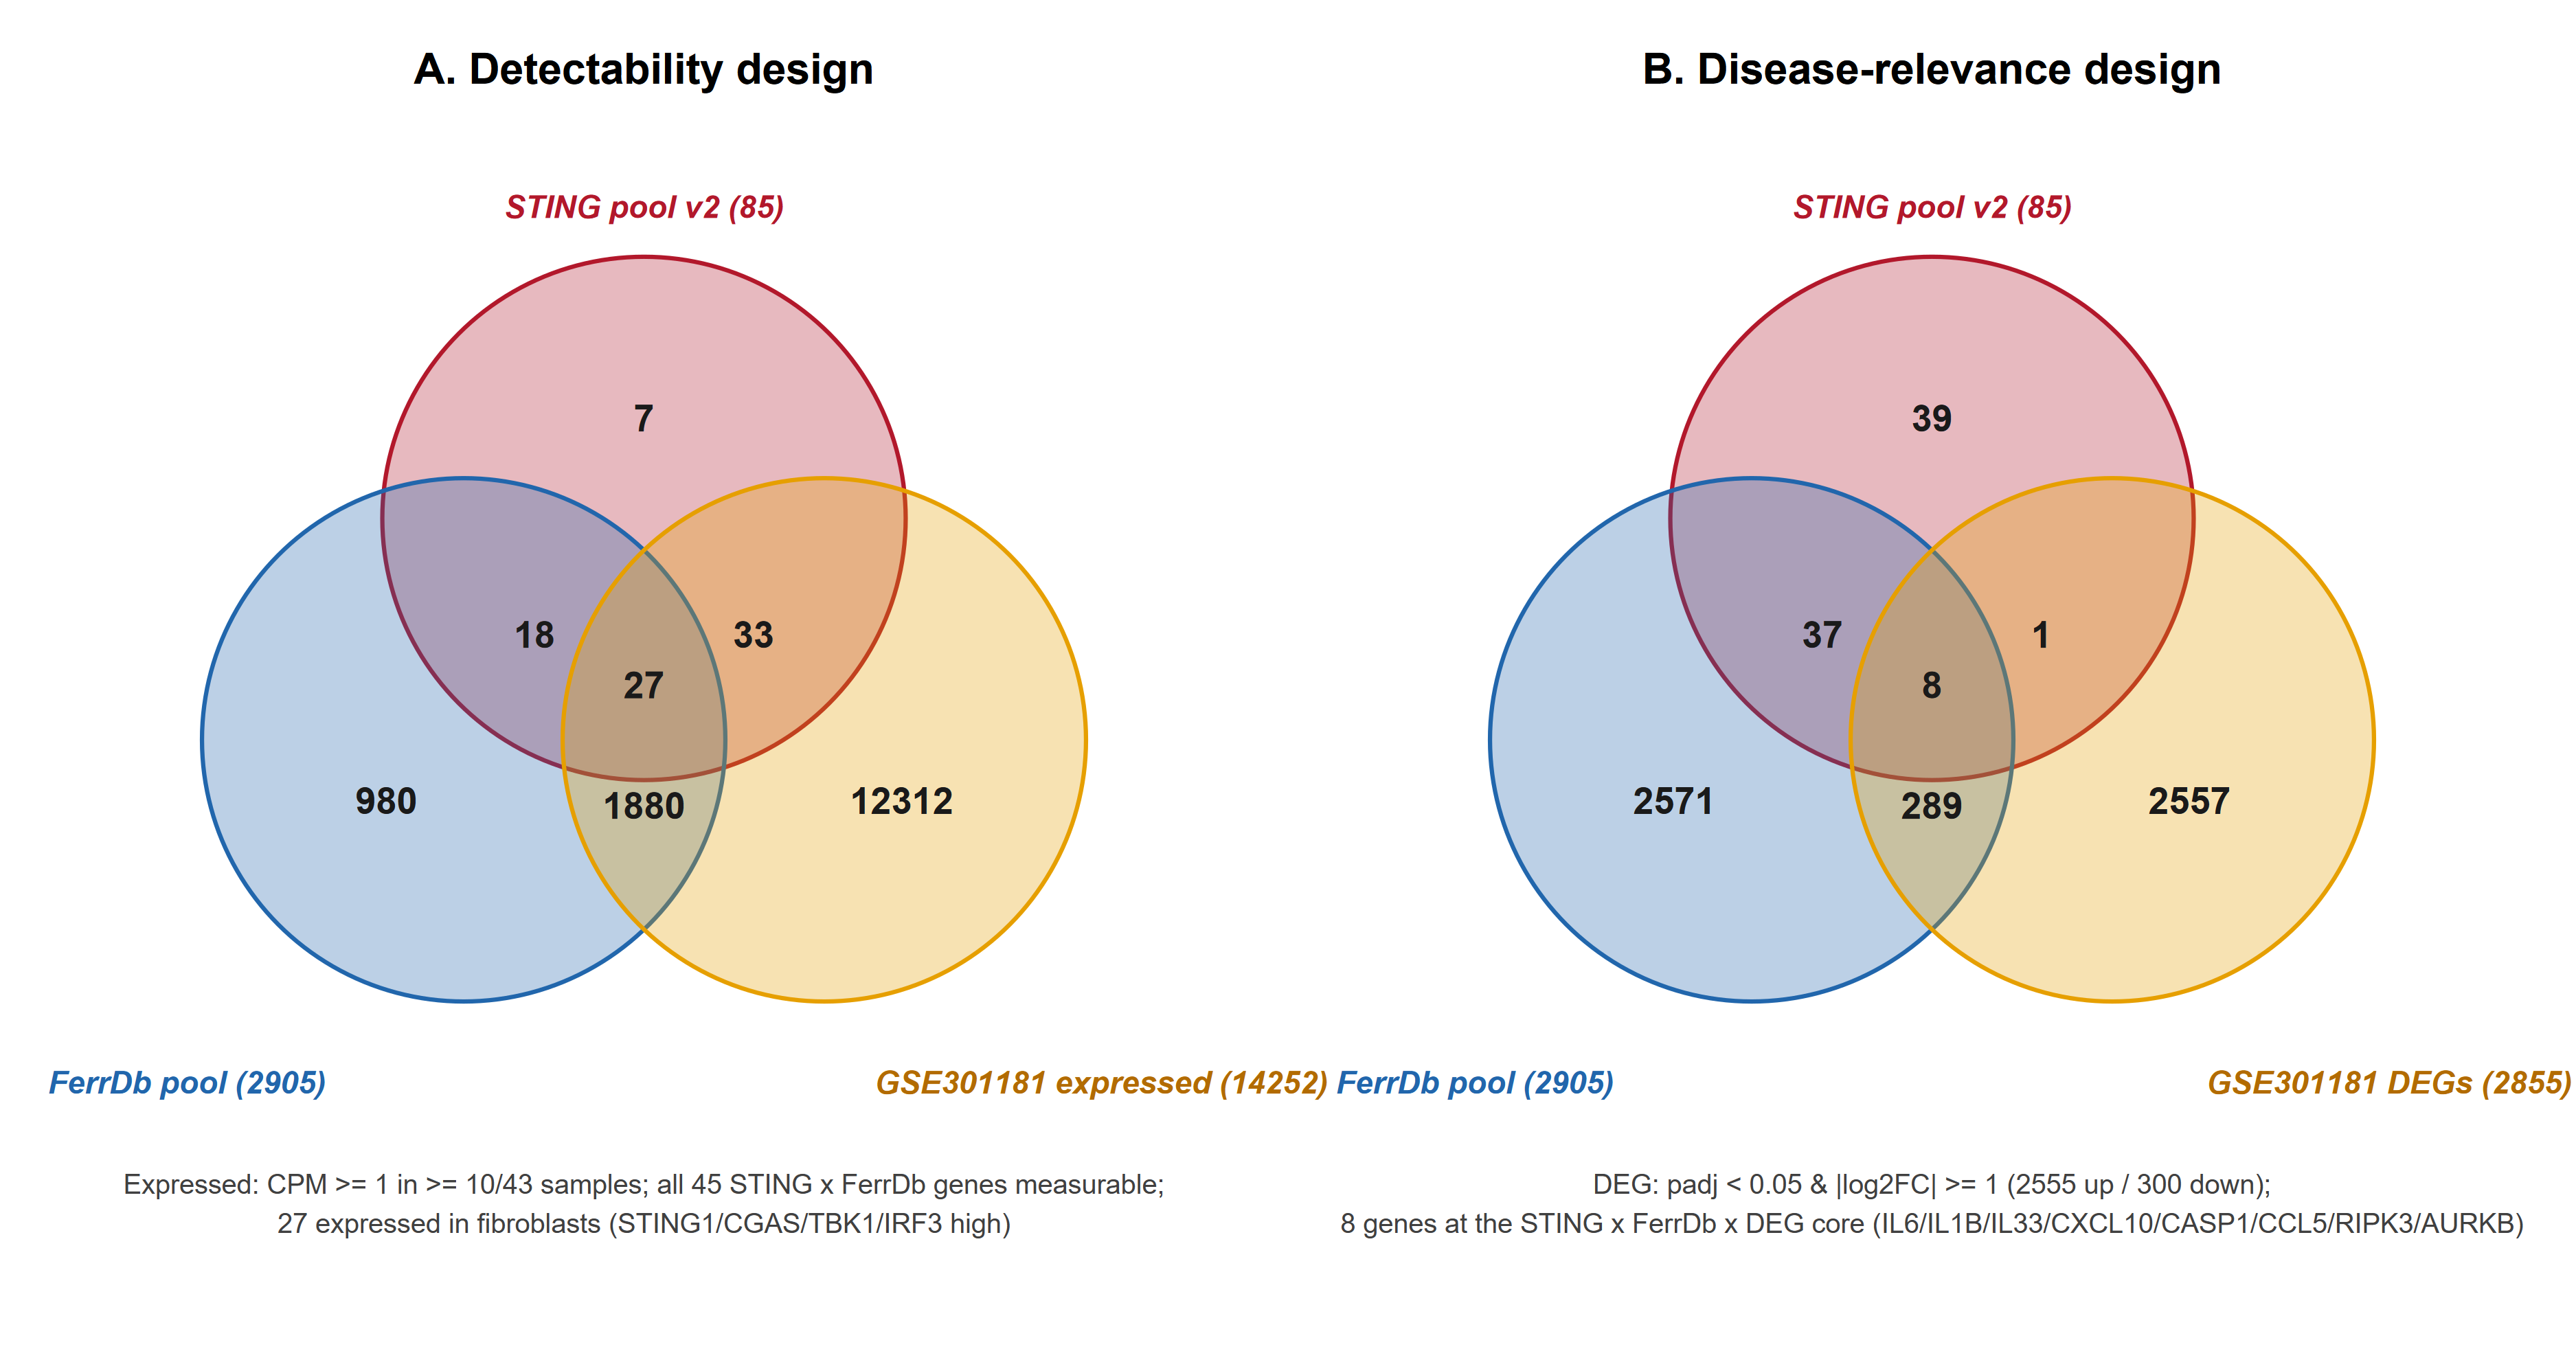
课题的交叉轴除了铁死亡(FerrDb),还有 cGAS-STING。把 cGAS-STING 通路基因池、FerrDb 铁死亡基因集、GSE301181(人原代肺成纤维,33 IPF vs 10 正常)的差异基因三个集合做 Venn 交叉,锁定 8 个同时落在三个集合里的基因(含 IL6、IL1B、IL33、CXCL10、CCL5 等)——它们既与铁死亡相关、又挂在 cGAS-STING 轴上、还在 IPF 成纤维细胞中差异表达,三条线索交汇在同一小撮基因上。
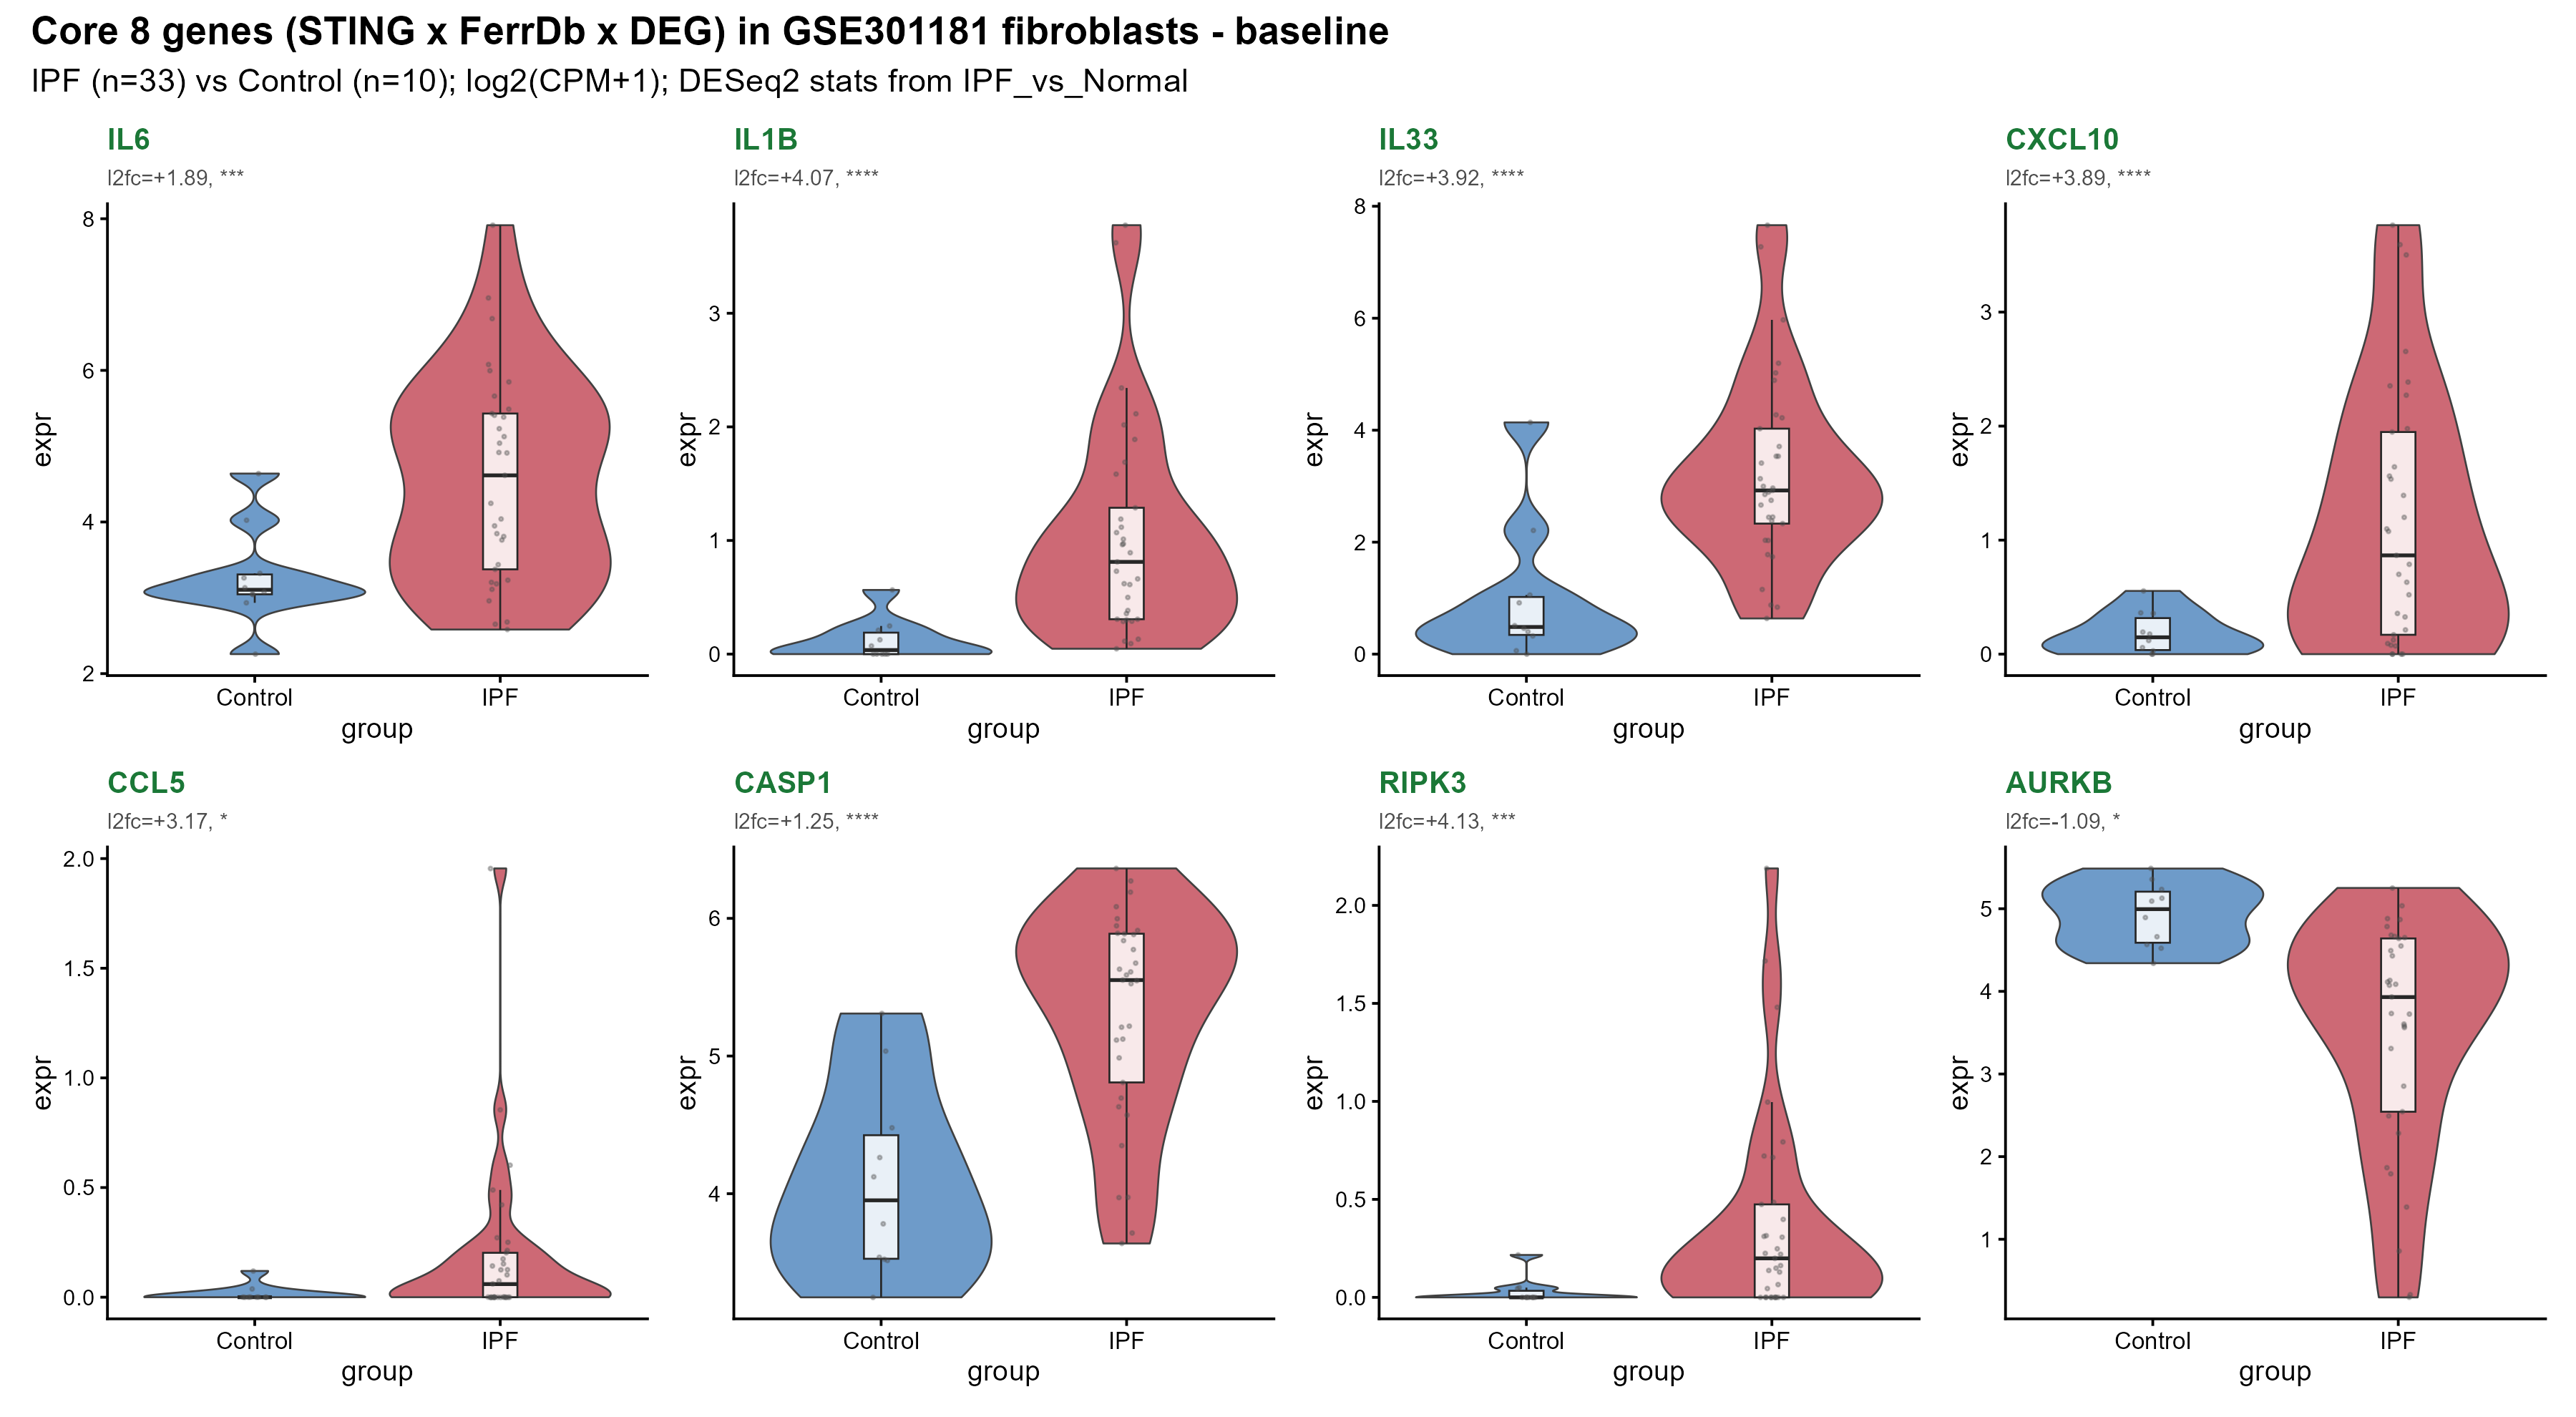
候选基因不能只在一个数据集里成立。把这 8 个基因拿到 4 个数据集里分别画小提琴图,看它们在疾病组与对照组中的表达分布,目前的观察是跨数据集方向一致。注意措辞:这是多数据集间的交叉验证结果,说明信号稳定、可重复,但不等于机制上的「证明」——因果层面的结论仍要等湿实验说话。
单细胞:第一批图已出
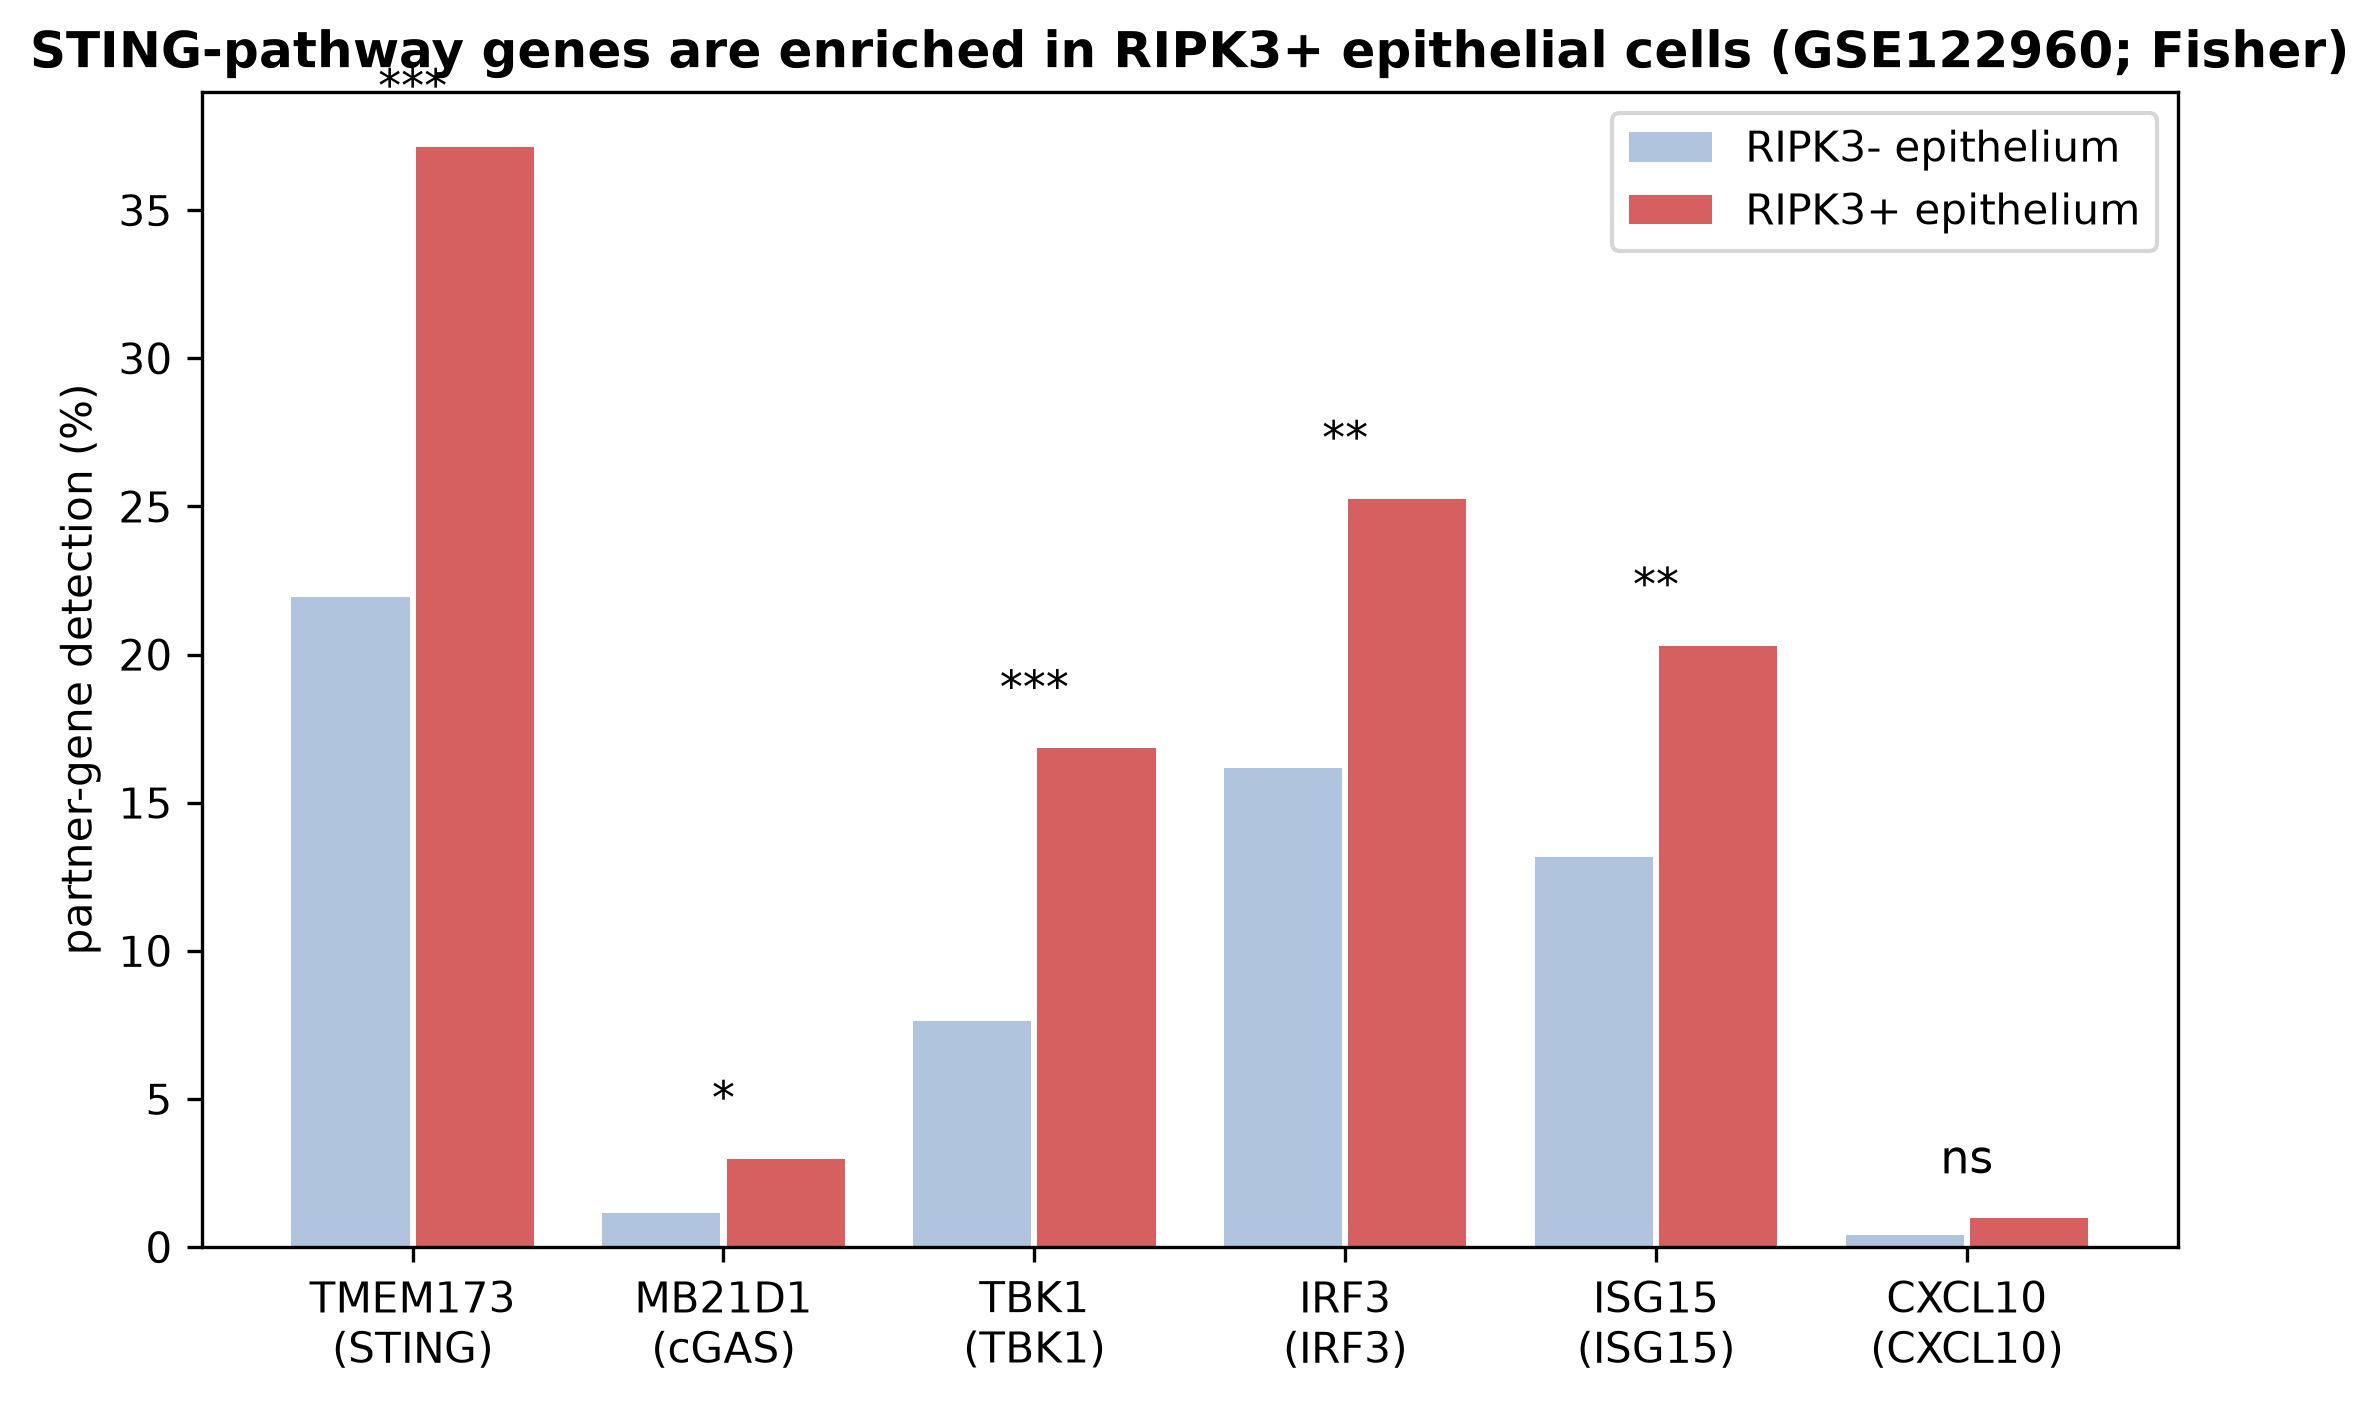
单细胞侧(主力数据集 GSE122960,流程详见下一节)目前聚焦两件事。其一,把 bulk 里看到的 cGAS-STING 线索下沉到单细胞分辨率:在注释好的上皮细胞中作 RIPK3 × STING 共表达,观察两者是否在同一群上皮细胞里同时激活——若共表达成立,就为「cGAS-STING 与细胞死亡程序在上皮细胞内交汇」提供了细胞层面的观察依据。
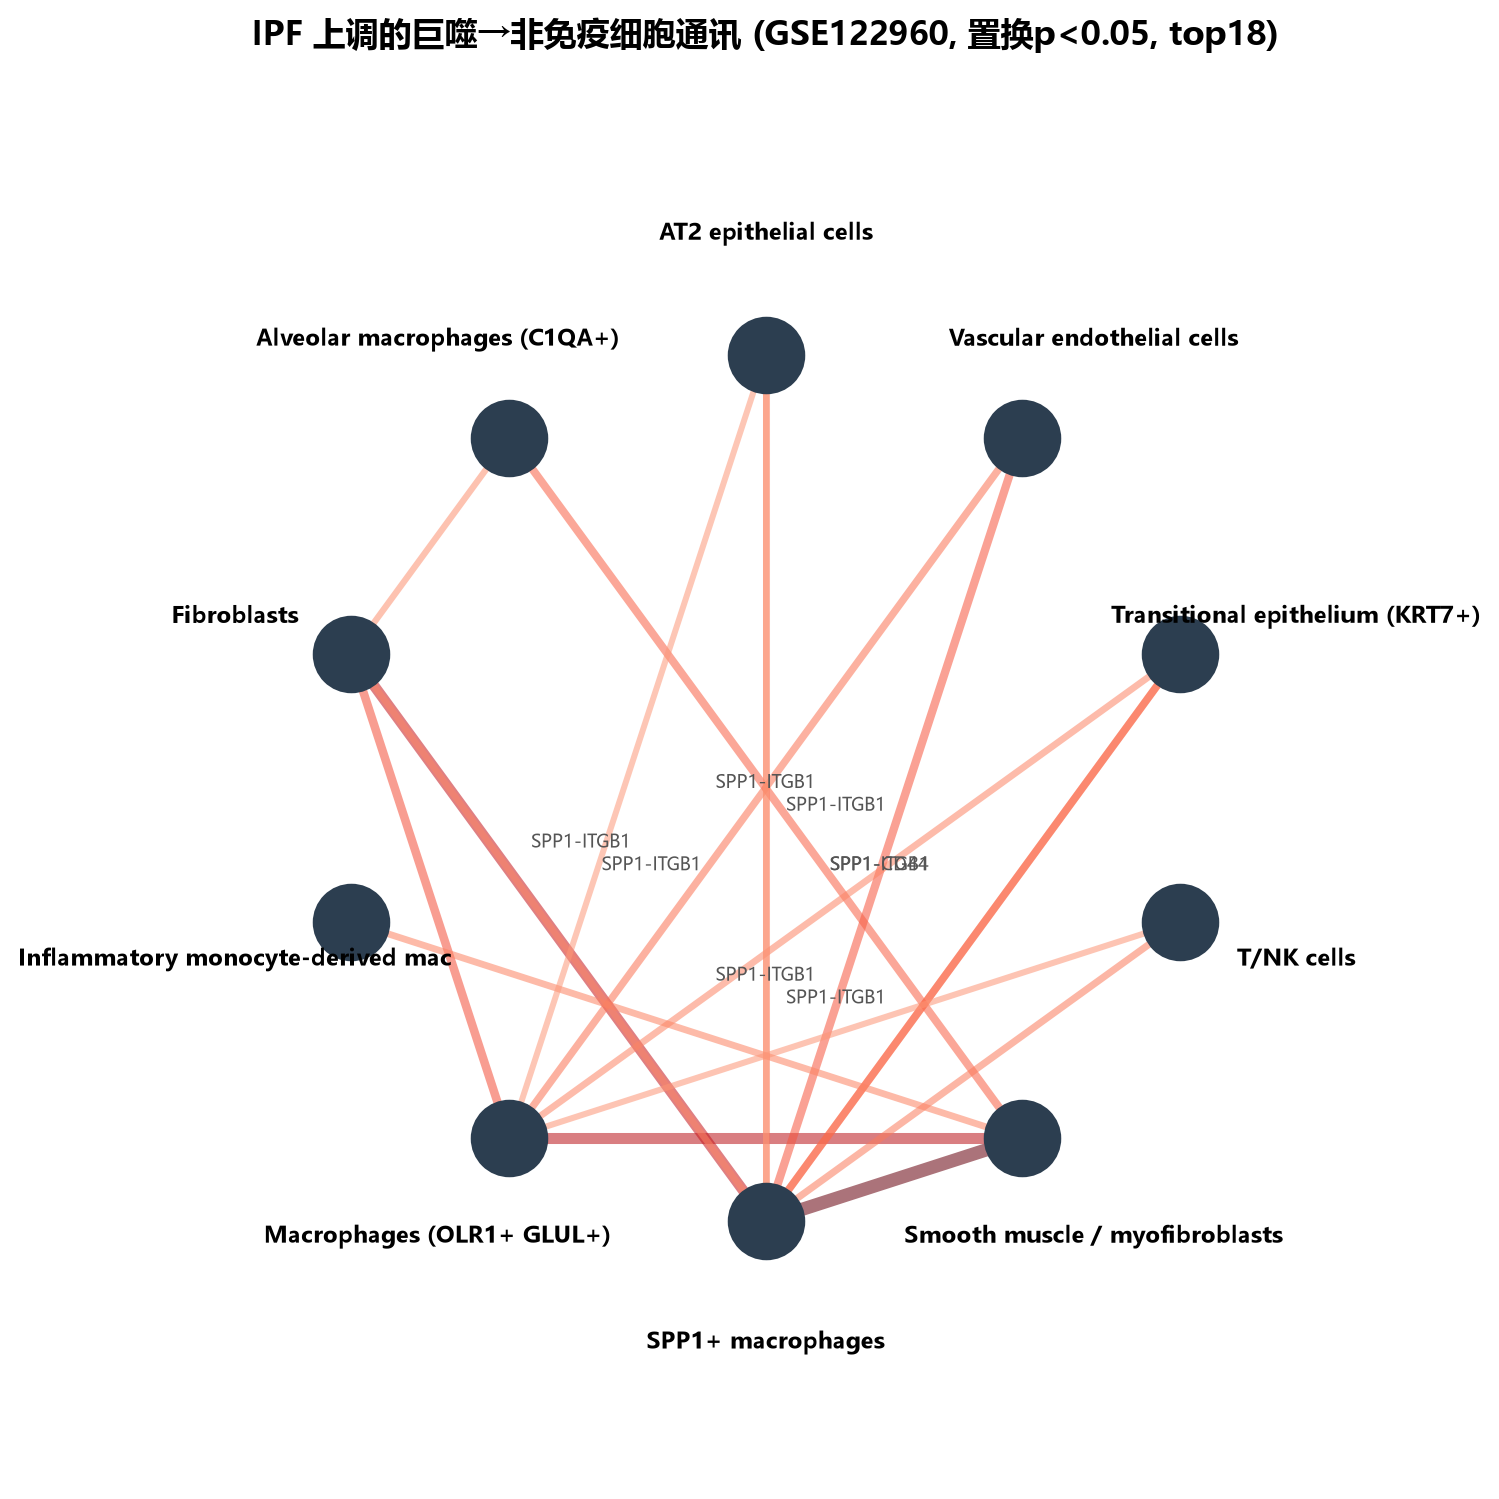
其二,细胞通讯分析(CellChat 类工具):基于配体-受体对推断细胞群之间的通讯网络。目前的弦图聚焦巨噬细胞 → 上皮细胞的输出方向,SPP1⁺ 巨噬细胞是其中显著的信号输出方——这与文献里「促纤维化微环境中的巨噬细胞亚群」的主流叙事方向一致。这部分分析仍在进行中,结论以最终定稿为准。
单细胞转录组(scRNA-seq)流程
bulk 测的是「一群细胞的平均」,如果目标细胞只占少数,它们的信号会被稀释掉。单细胞转录组把每一个细胞单独捕获测序,能看到「组织里有哪些细胞类型、各自处于什么状态、哪一群在疾病中扩张」。组内主力数据集是 GSE122960(人肺纤维化单细胞,GSE128033 做验证),流程跟 Seurat 官方教程走:QC → 标准化 → 降维聚类 → 细胞注释 → 聚焦上皮细胞 → 细胞通讯分析;课题组同时用 Python 的 Scanpy(读 h5ad 格式)处理同一批数据——R 与 Python 两条工具栈并用、结果互相印证,会哪边就用哪边。每步一句话:
自动注释工具给的细胞类型标签只是初稿,必须用 marker 基因人工核对(查 CellMarker 等数据库交叉验证);注释错了,后面所有「某群细胞在疾病中变化」的结论全部作废。这也是教程里反复强调、初学者最容易偷懒的一步。
常见误解 FAQ
| 误解 | 实际情况 |
|---|---|
| 生信 = 只有生物信息专业才能做? | 不是。主流流程都有详尽的开源教程(limma、clusterProfiler、Seurat 官方文档)可照抄,配 AI 辅助解读报错,本科生完全可以入门;需要的是生物学问题意识 + 耐心,而不是编程科班出身。 |
| 生信结果 = 结论? | 不是。公共数据集的样品背景、批次效应你控制不了,分析结果只是基于现有数据的假设,必须经自己的湿实验验证才能当结论讲(这就是「干湿结合」存在的理由)。我们自己的表述也遵循这个口径:跨数据集「方向一致」≠「证明」。 |
| 数据集随便挑一个都行? | 不行。要疾病对口(做 IPF 就选肺纤维化数据集)、分组明确、样本量合理(每组个位数样品的分析说服力有限);正式课题还应考虑用独立数据集做验证队列——本课题「1 个发现队列 + 多个验证队列」的布局就是这个道理。 |
严谨性提醒(务必阅读)
- 分析参数不许「凑结果」:阈值(如 |log2FC|、p 值)先按领域惯例定好再跑,跑完不满意就悄悄放宽重来,属于结果导向的数据操纵;参数与每一步的软件版本如实写进方法学记录;
- 代码和中间文件归档:每个图的作图脚本、输入矩阵、随机种子(seed)保存可溯,组会或投稿被问「这张图怎么来的」时要拿得出来——组内目前的做法是统一归档在工作电脑的课题目录下;
- 图表不许手工修:差异基因火山图、富集气泡图、小提琴图、弦图等一律由脚本生成,不在绘图软件里「美化」数据点的位置与大小。
组内信息
- bulk 转录组:7 个 GEO 数据集(见上文数据版图表)的分析体系已跑通;三队列 DEG 交集 280 个基因(方向 100% 一致),五队列共识铁死亡基因 167 个;cGAS-STING × 铁死亡 × GSE301181 三集合交叉锁定 8 个候选基因,并完成跨 4 个数据集的小提琴图验证(图 2、图 3);
- 单细胞:GSE122960 上皮细胞聚焦与细胞通讯分析进行中(GSE128033 独立验证),已产出 RIPK3 × STING 共表达图与巨噬-上皮通讯弦图(图 4、图 5);
- 工具与版本:R 统一用 4.5.2(旧版 4.0.3 / 4.3.3 已弃用),Seurat(R)与 Scanpy(Python,h5ad)并用;分析脚本与产出图在组内工作电脑归档,可溯可复现;
- 新人想参与:从跟跑 GSE301181 的差异分析复现开始,R / Python 均可——照归档脚本跑通流程、对上关键数字,就算入门了;
- 湿实验验证衔接:候选基因落到实验验证时,衔接 qPCR、Western Blot,安排见各篇组内信息。
学完之后
建议路径:先把图 1 的主线在 GSE134692(发现队列)上照教程完整跑通一遍(不求全懂,先求能出图);再换 GSE301181(人原代肺成纤维,33 vs 10)重复流程,体会「换个组织 / 细胞类型,结论怎么变」——这也是组内新人的标准入门路径(见上方组内信息)。单细胞方向则从 GSE122960 的 QC 与细胞注释跟起。每一步的产出(DEG 表、富集图、Venn、小提琴图)都存档并在组会讲一次。机制背景可配读 铁死亡、cGAS-STING 与 肺纤维化三篇;候选基因回到实验验证时,衔接 qPCR 与 Western Blot 教程。